你可能注意到了,有些 AI 工具的回复是"一个字一个字蹦出来"的,而有些是"等一会儿然后一整块出现"。前者就是流式输出。这一节介绍什么是流式输出,以及怎么在 Hermes 里打开它,顺便聊聊一个容易搞混的事情:流式输出和"思维过程"到底是什么关系。
14.1 两种输出方式
先说说你可能已经注意到、但没细想的现象。
用 ChatGPT 的时候,回复是一个字一个字蹦出来的,像有人在对面打字。而用某些 API 调用或者命令行工具时,你发了一条消息,界面转圈等了 10 秒,然后"唰"地一整段回复全出来了。
这两种体验的区别,就是流式输出和非流式输出的区别。
非流式(Non-streaming):客户端发送请求,等模型把所有内容都生成完毕,然后把完整的回复一次性返回。就像你给朋友发了一条消息,对方想好了之后一大段发过来。
流式(Streaming):模型每生成一小段内容(通常是一个或几个 token),就立刻通过网络推送到客户端,客户端收到一点就显示一点。就像对面有个人在实时打字给你看。
流式输出并不让模型"更快",它做的事情和做饭时"边炒边上菜"一样,总时间不变,但你更早看到东西。
该视频为课程站点内嵌片段,未收录于本地离线包;如需观看请回到线上课程对应课时。
14.2 在 Hermes 里打开流式输出
Hermes 默认是非流式的。也就是说,你发一条消息,它会安静地等模型把回复全部生成完,然后一次性显示出来。
打开方式很简单,在对话里跟 Hermes 说一句话就行:
> 帮我打开流式输出
Hermes 会自动帮你改好配置。这比手动编辑配置文件方便得多,大多数配置项都可以这样操作。
改完之后不需要重启,下一次对话就会生效。
打开之后,Hermes 的回复会一个字一个字实时显示出来,体验立刻变得生动很多。尤其在回复比较长的时候,你不用再盯着一个转圈的加载动画发呆。
14.3 一个容易搞混的事:流式输出 ≠ 思维过程
如果你在 Hermes 里打开了流式输出,你很可能会注意到一个"意外收获":模型在给出正式回答之前,会把它的思考过程详细地显示出来,就像这样:
  [Reasoning] 用户问的是关于量子纠缠的问题。
  让我想想该怎么解释...
  首先,量子纠缠是两个粒子之间的关联...
  然后,测量一个粒子会立即确定另一个的状态...
  好,我来组织一下语言。

量子纠缠是量子力学中最奇特的现象之一。
当两个粒子发生纠缠后,无论相隔多远...
实际效果:
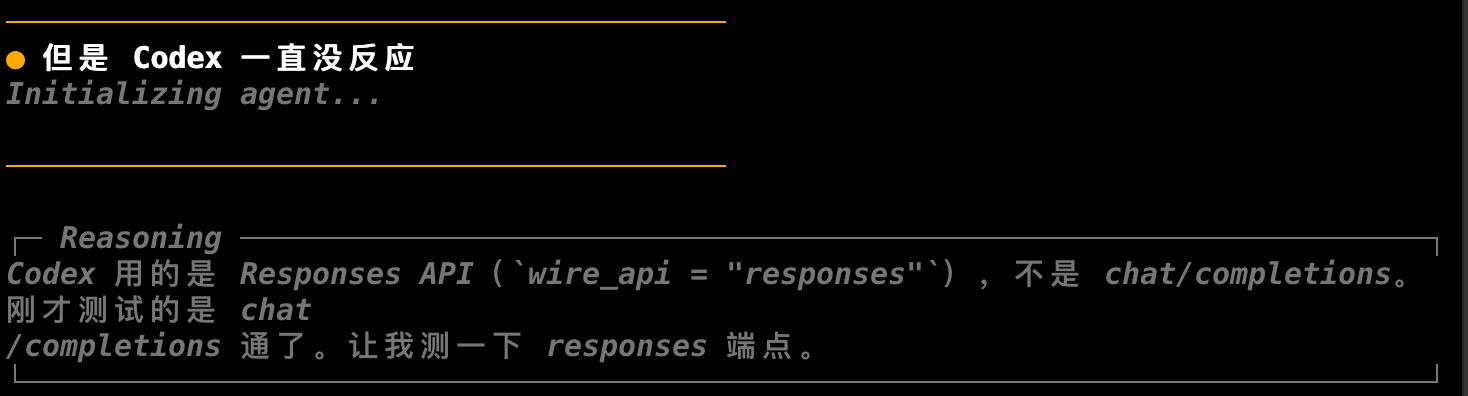
这段以 [Reasoning] 开头的内容,就是模型的思维过程(也叫推理过程、思考链)。在 Hermes 中默认是用灰色的字体输出的内容才是推理过程。
看到这个,很多人会以为"流式输出 = 能看到思维过程"。不是的,这是两回事。
流式输出是传输方式,解决的是"数据怎么传给你"的问题。不管模型在想什么,流式输出都会让回复逐字显示。
思维过程是模型能力,解决的是"模型在回答之前是否先做了推理"的问题。有些模型(比如 DeepSeek R1 的思维过程、OpenAI o 系列的 reasoning)在给出答案前会先生成一段内部推理,这些推理内容在 API 层面被标记为特殊类型。
那为什么你在 Hermes 里开了流式输出,就看到思维过程了呢?
因为在 Hermes 的当前实现里,显示思维过程的前提是必须开启流式传输。这两个功能在代码里是绑定在一起的:
if self.show_reasoning and self.streaming_enabled:
    return self._stream_reasoning_delta
只有当 streaming 和 show_reasoning 都为 true 时,Hermes 才会把模型返回的思维过程 token 实时显示出来。如果不开流式,就算你设了 show_reasoning: true,思维过程也不会显示。这是一个已知的限制。
换句话说: - 流式输出本身不产生思维过程,它只是让已有的思维过程能实时显示 - 思维过程是模型自己生成的,跟流式不流式无关 - 只不过 Hermes 目前只在流式模式下才展示思维过程
14.4 怎么控制思维过程的显示
如果你想看到 Hermes 的思维过程,需要同时打开两个开关。在对话里告诉 Hermes 就行:
> 帮我打开流式输出,并且显示你的思维过程
一句话,Hermes 会同时帮你把两个配置都改好。
也可以在对话过程中临时调整。/reasoning 命令有两类参数:控制推理深度,和控制思维过程的显示方式。
推理深度(Reasoning Effort)(控制模型"想多深"):
| 参数 | 作用 |
|---|---|
none |
不做推理,直接回答 |
minimal |
最低限度推理,适合简单任务 |
low |
轻度推理 |
medium |
中度推理(默认) |
high |
深度推理,适合复杂问题 |
xhigh |
最大强度推理 |
显示控制(控制你能不能"看到它在想什么"):
| 参数 | 作用 |
|---|---|
show |
显示思维过程 |
hide |
隐藏思维过程 |
on |
等同于 show |
off |
等同于 hide |
full |
显示完整的思维过程 |
clamp |
截断思维过程,只显示摘要 |
推理深度和是否显示思维过程是两件事。推理深度控制的是模型"想多深",显示控制决定的是你想不想"看到它在想什么"。
14.5 两种调整方式:持久设置 vs 临时调整
前面介绍的都是通过自然语言让 Hermes 帮你改配置,比如"帮我打开流式输出"。这种方式修改的是持久化设置,改完之后每次启动 Hermes 都会按新值来。
但有时候你只想在当前对话里临时看看思维过程,不想永久改配置。这时候可以用 /reasoning 命令:
> /reasoning show
这种临时调整只对当前会话有效,退出后失效,下次启动还是用之前的持久设置。
所以两者的关系是:自然语言对话定义持久默认值,/reasoning 在运行时做临时覆盖。大多数时候用自然语言设好默认值就行,偶尔需要临时调整推理深度或显示方式时,用 /reasoning 更方便。
14.6 推理能力是模型本身的功能
Hermes 里可以设置推理深度,但推理能力本身是大模型的功能,不是 Hermes 的功能。有的模型支持推理,有的模型不支持。那 Hermes 里的设置到底在控制什么?
简单说:Hermes 的设置是在模型支持的前提下给你一个调节旋钮。如果模型本身不支持推理,设置推理深度没有实际效果。
下面是当前主流模型的推理能力支持情况(截至 2026 年 7 月):
国内模型
| 模型 | 推理能力 | 控制方式 | 说明 |
|---|---|---|---|
| DeepSeek V4 Pro/Flash | 支持 | enable_thinking + reasoning_effort |
可在思考与非思考模式间切换,推理深度支持 low/medium/high/xhigh/max |
| DeepSeek R1 | 仅思考 | 无法关闭 | 专为推理设计,总会思考,不支持关闭或调整深度 |
| 智谱 GLM-5/5.2 | 支持 | thinking mode | 有思考模式开关 |
| 通义千问 Qwen3.7 | 支持 | 待确认 | 阿里云百炼新模型 |
| Kimi K3 | 支持 | thinking.effort / reasoning_effort |
月之暗面最新旗舰,2.5万亿参数,支持100万上下文 |
国外模型
| 模型 | 推理能力 | 控制方式 | 说明 |
|---|---|---|---|
| OpenAI GPT-5.6 | 支持 | reasoning_effort |
OpenAI 最新旗舰,内置推理能力 |
| Claude Opus 4.8 | 支持 | Extended Thinking + Adaptive | Anthropic 判断力与安全旗舰 |
| Claude Fable 5 | 支持 | Extended Thinking | Anthropic 最新 Mythos 级别模型,创意推理旗舰 |
从表里可以看出,2026 年的主流模型基本都支持某种形式的推理能力。区别在于控制方式不同:有的用 reasoning_effort,有的用 enable_thinking,有的用 thinking 参数。
Hermes 的 /reasoning 命令实际上是在尝试把这些不同的参数统一起来。但具体能不能生效,取决于你当前使用的模型是否支持。如果模型本身不具备推理能力,设置推理深度不会有任何效果。
日常简单问答,没必要看思维过程,关掉就好,终端显示干净。 当你发现 Hermes 的回答不太对、漏了什么、或者逻辑奇怪的时候,使用 /reasoning 来灵活控制。看看它在想什么,通常能很快发现问题出在哪一步。这对调试很有帮助。
14.7 思考模式与费用:两个容易误解的问题
开启思考模式之后,有两个问题值得了解清楚:它是不是更贵?显示思维过程是不是更费 token?
以 DeepSeek V4 Pro 为例来说明。
思考模式比非思考模式贵吗?
单价不变,但总花费会变高。
DeepSeek V4 Pro 的输出价格是 0.87 美元/百万 token(折扣后),不管是否开启思考模式,这个单价都一样。区别在于,开启思考模式后,API 返回的内容多了一个 reasoning_content 字段,也就是模型的思考过程。这部分内容也按输出 token 计费。
换句话说,思考模式下你的输出 token 变多了(思考过程 + 正式回答),总费用自然就高了。同一个问题,非思考模式可能只输出 200 个 token,开启思考模式后可能输出 1500 个(其中 1300 个是思考过程)。单价没变,但你付了更多的 token。
显示思维过程比隐藏更费 token 吗?
不会。这是两件事。
思考过程在 API 层面一定会生成并返回,不管你在 Hermes 里选择 show 还是 hide。显示和隐藏只是客户端的展示设置:show 让你看到思考过程,hide 只是不显示出来。模型该想的还是在想,API 该返回的 reasoning_content 还是在返回,token 该消耗的还是在消耗。
所以,在 Hermes 里切换 show/hide 对 token 用量没有任何影响,对费用也没有影响。你只是决定了自己看不看得到它,并没有改变模型的行为。
14.8 流式输出在消息平台上
Hermes 不只跑在终端 CLI 里,还可以接入微信、飞书等消息平台。在这些平台上,流式输出的体验不太一样。
终端 CLI 里,流式输出就是逐字打字。但在消息平台上,情况要复杂一些。
飞书等现代 IM 工具支持一个能力:消息发出之后,你还可以修改它的内容。对方看到的不是新消息,而是原来那条消息的文字变了。这就是"编辑消息"(Edit Message)。有了这个能力,就可以先发一条消息出去,然后随着内容不断生成,反复更新这条消息的内容,实现"逐渐变长"的流式效果。微信不支持这个能力,消息一旦发出去就不能再修改。
飞书支持编辑消息。Hermes 在飞书上的做法是:先发出第一条消息,然后随着模型生成更多内容,不断编辑这条消息来更新。效果也是"逐渐变长",和终端里的逐字打字体验接近。
微信不支持编辑消息。微信 API 的限制决定了没办法像飞书那样"更新一条消息"。Hermes 会使用分段发送这样的模式来给微信发消息。
配置消息平台的流式输出,直接告诉 Hermes 就行:
> 帮我配置消息平台的流式输出,用编辑消息的方式,每0.3秒更新一次
Hermes 会自动检测当前平台是否支持消息编辑。如果平台不支持(比如微信),它会自动切换到分段发送模式,不会刷屏。
14.9 ■ 学点英语
| 中文 | English | 音标 | 说明 |
|---|---|---|---|
| 流式输出 | Streaming Output | /ˈstriːmɪŋ ˈaʊtpʊt/ | 模型边生成边传输,客户端逐字显示 |
| 思维过程 | Thinking Process / Reasoning | /ˈθɪŋkɪŋ ˈprɒses/ | 模型在回答前生成的内部推理内容 |
| 思维链 | Chain of Thought (CoT) | /tʃeɪn əv θɔːt/ | 逐步推理的方法论,常用于提示词工程 |
| 令牌/词元 | Token | /ˈtoʊkən/ | 大模型处理文本的最小单位 |
| 服务器推送事件 | Server-Sent Events (SSE) | /ˈsɜːrvər sent ɪˈvents/ | 实现流式输出的网络协议,服务端单向推送数据到客户端 |