上一节讲了 MEMORY.md 存什么、不存什么。但有些事情不值得占记忆空间,只需要在某个时刻被翻出来。这一节就讲怎么翻。
4.1 场景一:捡回断掉的思路
周一搭了一个 FastAPI 项目骨架,用 SQLAlchemy 做 ORM,但不确定当时选的数据库驱动是 asyncpg 还是 psycopg。周三坐下来,不用重新描述一遍需求,直接问 Hermes:
「上次那个 API 项目,数据库用的是 asyncpg 还是 psycopg?」
Hermes 会调用 session_search,在历史会话里全文搜索,找到周一那场讨论,直接给出答案。从提问到拿到结果,十几毫秒的事,不需要自己翻文件。
4.2 场景二:跨平台无缝切换
通勤路上用微信给 Hermes 发了一句「帮我研究一下 RAG 的几个主流方案对比」,到公司坐下,终端里直接一条命令:
hermes -c "RAG"
刚才微信里的讨论全回来了。hermes -c 会自动查找标题匹配的最新会话,把历史记录恢复到当前对话。同样的效果,用 -r 可以按会话 ID 精确恢复:
hermes -r 20260510_174648_805cc2
会话 ID 在每次退出会话时都会显示在终端上,记不住也没关系,hermes sessions list 可以浏览最近的所有会话。
4.3 场景三:回顾决策过程
假设你曾经和 Hermes 共同制作过一个漂亮的 HTML。几周后你想回顾下这个过程,复刻同样的风格制作新的页面,不用重新描述过往的试错过程,直接问 Hermes:
「上次我们制作的那个漂亮HTML,我记得改了好几版才定下来。能不能帮我找到那次对话?」
session_search 会搜到那一整段迭代过程:
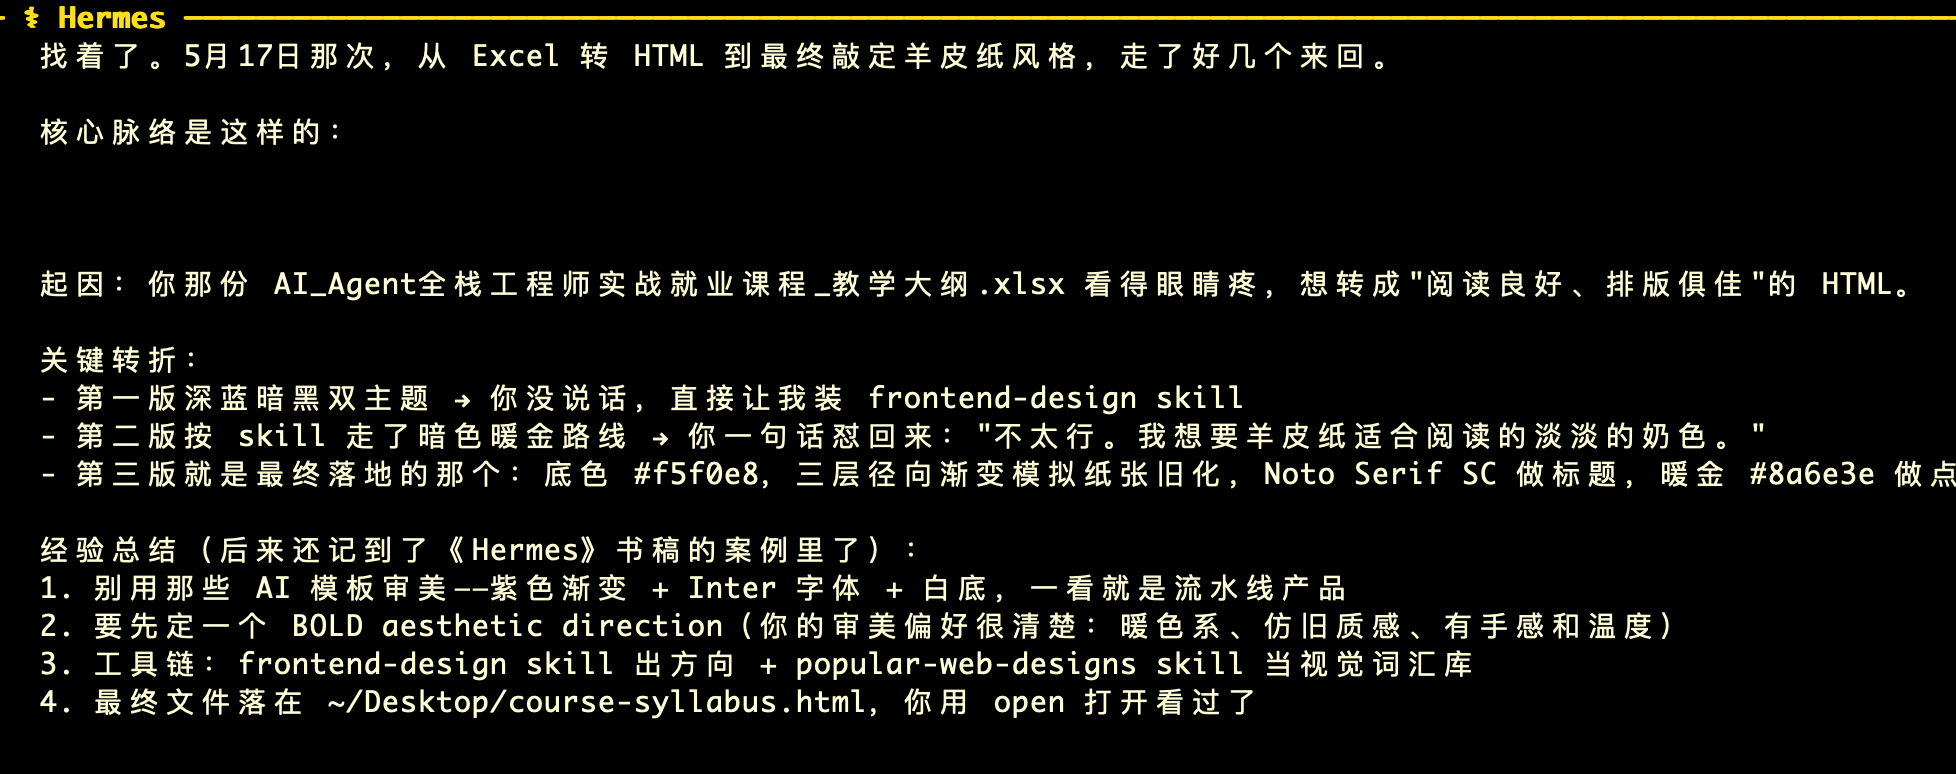
是不是很棒?它不是只给你丢消息记录,而是会把整个会话的脉络都摘要出来。
4.4 hermes sessions list 指令
hermes sessions list 列出所有历史会话记录。运行之后看到的是这样的表格:
Title                  Preview                           Last Active   ID
────────────────────────────────────────────────────────────────────────────
RAG 方案对比           帮我研究一下 RAG 的几个主流方案对比  2h ago        20260510_174648_a
数据库选型             团队问你线上那套方案为什么选它       3d ago        20260428_143022_c
—                      每日市场简报已推送                    1d ago        20260504_091523_b
四列分别对应:标题(Hermes 自动生成,3-7 个词)、预览(第一条消息的摘要)、最近活跃(相对时间)、会话 ID(创建时间+随机后缀)。
几个值得注意的地方:
- 有标题的行是交互式对话——你跟 Hermes 聊过天,首次交换消息后自动生成了标题。
- 标题为
—的行是非交互式会话——比如 cron 定时任务(记得之前备忘录主动定时提醒吗?),没有用户参与对话,所以不会触发自动命名。 - 想知道某条记录来自哪个平台(CLI、飞书、Telegram),用
hermes sessions list --source feishu过滤。
4.5 几个实操建议
给关键会话起个名字。 Hermes 会自动给每个会话生成一个 3-7 个词的标题,在 sessions list 里就能看到。但如果想精确搜索和恢复,可以手动改一个更容易记住的名字。
在当前会话中输入 /title 数据库选型,之后就能用 hermes -c 数据库选型 直接恢复。
容量不是问题。 上一节说过 MEMORY.md 有 2,200 字符限制,得精打细算。但会话历史没有硬性上限。所有对话自动存在 SQLite 数据库里,FTS5 全文索引。一条搜索命令平均 15-50 毫秒,不消耗任何 Token。
不用手动整理。 Hermes 自动存储、自动生成标题、自动建立全文索引。删也不需要担心,过期的会话可以用 hermes sessions prune 按时间清理,90 天以前的会话自动进入清理范围。导出也很方便,hermes sessions export 可以一次把全部或指定会话导出成 JSONL 文件。
4.6 ■ 学点英语
| 中文 | English | 音标 | 说明 |
|---|---|---|---|
| 会话历史 | Conversation History | /ˌkɑːnvərˈseɪʃən ˈhɪstəri/ | 保存过往对话内容和任务过程的记录 |
| 跨会话检索 | Cross-Session Retrieval | /krɔːs ˈseʃən rɪˈtriːvəl/ | 从不同会话记录中找回相关信息的能力 |
| 全文检索 | Full-Text Search | /fʊl tekst sɜːrtʃ/ | 在大量文本中查找关键词或相关内容的技术 |
| 相关性排序 | Relevance Ranking | /ˈreləvəns ˈræŋkɪŋ/ | 按匹配程度给搜索结果排序的机制 |