RTK(Rust Token Killer)是一个 CLI 代理工具,能自动压缩 shell 命令的输出,让 AI 工具消耗的 Token 减少 60-90%。
该视频为课程站点内嵌片段,未收录于本地离线包;如需观看请回到线上课程对应课时。
7.1 RTK 是什么
RTK 的全称是 Rust Token Killer,一个开源的命令行工具。它做的事情很简单:拦截你执行的 shell 命令,压缩输出内容,然后再把压缩后的结果返回给调用者。
这个"调用者"通常就是 AI 工具。当 Hermes 或 Claude Code 需要执行 git status、ls -la、cargo test 这些命令时,RTK 会在中间做一层处理,把冗长的输出精简成只保留关键信息。
举个例子,普通的 git diff 可能输出几百行代码变更,RTK 处理后可能只保留几十行,但不会丢失关键信息。AI 工具拿到压缩后的输出,依然能理解代码变化,但消耗的 Token 大幅减少。
RTK 用 Rust 编写,性能开销低于 10ms,单二进制文件零依赖,安装后几乎感觉不到它的存在。
7.2 压缩命令输出为什么能减少 Token
这里有一个容易让人困惑的地方:Token 消耗不是来自大模型的输入和输出吗?压缩 shell 命令的输出,为什么能影响 Token 数量?
这里你需要先知道一个 Agent 的基本工作原理,其实 Agent 的基础工作原理非常简单,它就是通过循环调用 Tool 工具来分步骤完成任务,大模型能做的非常有限,就是决策调用什么工具。所以产生的 Token 均来自工具的输入输出。
而AI 工具执行命令时,命令的输出会被注入到模型的上下文窗口。
当你用 Hermes 或 Claude Code 时,它们并不只是"看"你的文件,还会主动执行命令来获取信息。比如:
- 执行
git status查看哪些文件被修改了 - 执行
cargo test看测试结果 - 执行
ls查看目录结构 - 执行
cat读取文件内容
这些命令的完整输出,会被 AI 工具原封不动地注入到发给大模型的 prompt 里。如果 git diff 输出了 500 行,这 500 行就会全部进入上下文,按 Token 计费。
RTK 做的事情,是在命令输出和 AI 工具之间加一层过滤。命令照常执行,但输出被压缩后再返回。AI 工具拿到的还是命令结果,只是更精简。
普通流程:
命令执行 → 完整输出 → 注入 AI 上下文 → 发送给大模型 → 消耗 Token

使用 RTK:
命令执行 → 完整输出 → RTK 压缩 → 精简输出 → 注入 AI 上下文 → 发送给大模型 → 消耗更少的 Token
这就是为什么压缩 shell 输出能减少 Token 消耗。RTK 不改变命令的执行逻辑,只优化输出的呈现方式。
7.3 RTK 的压缩策略
RTK 不是简单的"删除行",而是针对不同命令设计了几种压缩策略:
智能过滤。 对于 git log 这种命令,RTK 会移除不必要的空行、重复的分隔符,但保留提交信息、作者、时间等关键内容。
分组聚合。 对于 ls 或 find 输出大量文件时,RTK 会按类型或目录分组,用摘要代替逐行列举。
智能截断。 对于 cat 读取大文件或 cargo test 输出大量日志时,RTK 会保留开头和结尾的关键信息,中间部分用省略号代替。
去重统计。 对于 grep 或 rg 搜索结果,RTK 会统计匹配数量,但只展示代表性的几行,而不是全部列出。
这些策略都是针对具体命令定制的,不是通用的"删除 N 行"。RTK 内置了 100 多个命令的压缩规则,覆盖日常开发中最常用的工具。
7.4 安装
RTK 的安装方式有几种,选最顺手的就行:
# macOS 用户推荐用 Homebrew
brew install rtk

# 或者用官方安装脚本
curl -fsSL https://raw.githubusercontent.com/rtk-ai/rtk/refs/heads/master/install.sh | sh

# Rust 用户可以直接 cargo install
cargo install --git https://github.com/rtk-ai/rtk
安装完成后,可以验证一下:
rtk --version
如果正常输出版本号,说明安装成功。
7.5 与 AI 工具的集成
RTK 需要告诉 AI 工具"以后执行命令时,通过我来"。这个过程叫"初始化",不同工具的命令略有不同:
# 为 Hermes 初始化
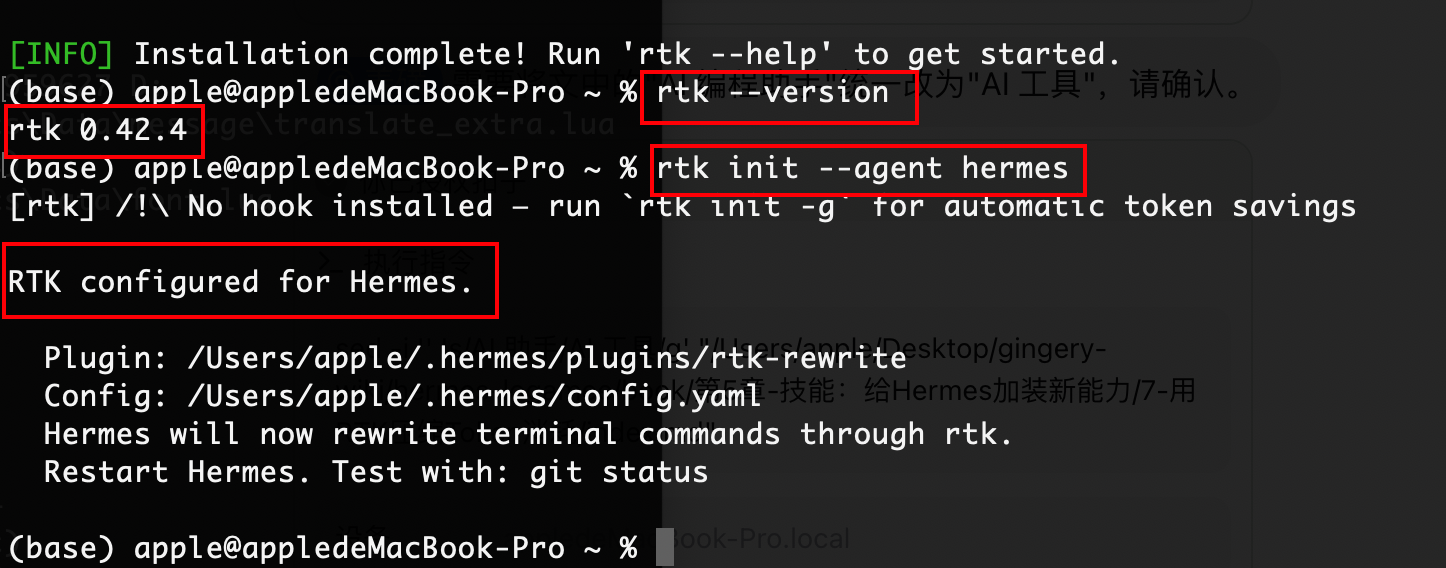
rtk init --agent hermes

# 为 Claude Code 初始化
rtk init -g

# 为 Gemini CLI 初始化
rtk init -g --gemini

# 为 ChatGPT 初始化
rtk init -g --codex

# 为 Cursor 初始化
rtk init -g --agent cursor
这些命令会在对应的 AI 工具配置中添加 RTK 的包装规则。初始化后,AI 工具执行命令时会自动通过 RTK,不需要你手动干预。下面是 Hermes 的几个步骤执行结果:
如果同时使用多个工具,可以多次执行初始化,互不影响。
以下没有查到官方资料,但是我在测试中存在这样的问题。初始化后,RTK 并不会立即生效,必须在一个全新的会话中,RTK 才会生效。
hermes    # 启动一个全新会话,RTK 生效
/new    # 启动一个新会话,RTK 生效
所以,hermes -c,虽然是一个新进程,但对话历史会被带回来。历史中积累的旧命令模式(没有 rtk 前缀的命令)会影响 Agent 的行为,导致 RTK 失效。
换句话说,只要会话里有历史对话记录,RTK 就可能不生效。每次使用前,都需要 hermes 启动一个干净的会话。
RTK 对不同 AI 工具的集成方式和实际效果差别很大:
- Hermes:通过 Python 插件集成,自动重写命令。在新会话中效果最好,但恢复旧会话后同样可能失效。
- Claude Code:通过 PreToolUse hook 集成,自动重写 Bash 命令。只拦截 Bash 工具调用,内置的 Read、Grep、Glob 等原生工具不会被拦截。
- ChatGPT CLI:没有 hook 机制,只能通过 AGENTS.md 里的文字指令让模型自觉加
rtk前缀。实测效果最不稳定——即使 Agent 输出了rtk前缀的命令,rtk gain统计也可能没有记录。
总的来说,RTK 对 CLI 命令输出的压缩率确实很高(单条命令可达 60-90%),但它只覆盖 Bash 命令输出这一层。对话历史、源码文件、系统提示词占的 Token 它碰不到。而且实际会话级别的整体节省比例远低于宣传值,通常在 20-50% 之间。
7.6 常见用法
初始化完成后,日常使用几乎是无感的(即你根本不需要管)。但 RTK 也提供了一些独立的命令,可以手动调用。
用 rtk 前缀执行命令
即使没有初始化,也可以直接用 rtk 前缀执行命令,手动体验压缩效果:
rtk ls -la
rtk git status
rtk git diff
rtk cargo test
rtk cat large_file.log
这些命令的输出会被压缩,但功能完全正常。
查看节省了多少 Token
RTK 提供了一个 gain 命令,可以统计压缩节省了多少 Token:
rtk gain
输出类似:
RTK Token Savings (Global Scope)
════════════════════════════════════════════════════════════

Total commands:    2
Input tokens:      4.9K
Output tokens:     1.6K
Tokens saved:      3.3K (67.2%)
Total exec time:   52ms (avg 26ms)
Efficiency meter: ████████████████░░░░░░░░ 67.2%
拿上面的例子来说:2 条命令,原始输出 4.9K Token,压缩后剩 1.6K,省了 67%。处理的额外开销才 52 毫秒,几乎感觉不到。
这个数据能让你直观看到 RTK 的效果。
支持的命令
RTK 内置了 100 多个命令的压缩规则,常用的包括:
- Git 系列:
git status、git diff、git log、git push、git pull - 构建与测试:
cargo test、cargo build、npm test、pytest、go test - 文件操作:
ls、cat、find、grep、rg - 容器与云:
docker ps、docker logs、kubectl get pods - 系统工具:
ps、top、df、du
完整的命令列表可以通过 rtk --help 来查看所有支持的 rtk commands。
你可能会想:我跟 Agent 说的明明是自然语言,怎么冒出来一堆 git status、grep、cat?因为 Agent 接到你的高级任务(比如「帮我改一下登录模块」)后,会自己拆解成一系列低阶操作:先 cat 读代码、再 grep 搜索关键逻辑、改完用 git diff 对比改动。你的一句话,在底层就是几十条命令。RTK 压缩的就是这些命令的输出,它们才是 Token 消耗的大头。换句话说,只要 Agent 使用这些命令就有可能节省 Token,如果不使用,那就省不了。
7.7 实际效果:聊胜于无
RTK 虽然宣称能节省 60-90% 的 token,但实际使用中效果有限,原因有三:
1. 覆盖范围有限
RTK 只压缩 shell 命令的输出。但很多 LLM 平台有内置工具不经过 shell,比如: - 文件读取工具(Read) - 搜索工具(Grep、Glob) - 代码编辑工具(Edit)
这些工具不通过 shell 执行,RTK 无法介入压缩。在 Hermes、Claude Code 等 Agent 中,大量操作使用的是这些内置工具,而非 shell 命令。
2. 语义信息丢失的代价
Hacker News(国外知名技术社区)上有用户指出:RTK 宣传的"节省的 token 就是省下的钱"("Tokens saved are tokens saved")不是永远成立的。压缩有时候会丢掉语义信息,你省了 70% 的 tool call token,但可能因此多打了 3 轮对话去恢复被移除的内容,综合下来反而更亏。
3. 整体 token 消耗占比小
Shell 命令输出可能只是总 token 消耗的一部分。一个30分钟的会话中: - 对话历史:可能占50-70% - 文件内容:可能占20-30% - Shell 命令输出:可能只占 10-20%
即使 shell 命令的 token 减少了 80%,整体 token 消耗可能只减少 10-15%。
结论
RTK 适合高频使用 shell 命令的场景(比如纯 CLI 开发)。但对于使用 Agent 的场景,实际节省的 token 可能只是「聊胜于无」。更有效的 token 优化策略是: - 缩短对话历史(使用summary、定期清理) - 按需加载文件(而非全量读取) - 使用上下文压缩技术
7.8 ■ 学点英语
| 中文 | English | 音标 | 说明 |
|---|---|---|---|
| Token 压缩 | Token Compression | /ˈtoʊkən kəmˈpreʃən/ | 减少命令输出或上下文占用的处理方式 |
| 命令代理 | Command Proxy | /kəˈmænd ˈprɑːksi/ | 包在原命令外层、负责过滤或改写输出的工具 |
| 输出过滤 | Output Filtering | /ˈaʊtpʊt filtering/ | 从命令输出中保留关键信息并去掉噪声 |
| 语义损失 | Semantic Loss | /sɪˈmæntɪk lɔːs/ | 压缩或过滤后丢失原始含义的风险 |