这一章开始正式开发胶囊系统。先不要调用 Spec Kit,也不要急着生成 SPEC;这一节要做的是把前面已经确定的设计收拢成一份需求简报。后面的 $speckit-specify 会把这份简报作为输入,所以要先确认它表达的确实是我们想做的系统。
1.1 规范开发 VS Prompt 开发
大多数人做 Vibe-Coding 开发,都是自己写一段 Prompt 然后丢给 Agent 去生成代码。有问题后,再告诉 Agent 错在哪里,然后 Agent 再修改。
这种方法可行吗?可行。但前提条件是,这个项目不是一个商业化的项目。这种方式会给项目埋下很大的隐患。
你不要说,我做的东西没有隐患。这可能只是这些隐患没有爆雷。或者是这些隐患发生了也就发生了,比没有多大的损失。
但假设出现一个印花需要罚款 100 万,你还会这样开发项目吗?换一个角度来讲,纯粹的 Prompt 开发不值得我们花时间去讨论讲解——你想怎么做直接告诉 Agent 即可。
胶囊系统开发采用的是规范的驱动开发,所以会非常复杂和枯燥。他需要经过多轮打磨调整,需要人机协作,共同完成从需求简报到 SPEC 再到 Plan、Task 文档的开发,最后再交给 Agent 生成代码。
枯燥是没办法的。因为现在的主流开发方式都从写代码变成了写文档,这是趋势和主流,要适应。
1.2 把已有设计收拢到一页纸上
前面已经讨论了胶囊系统要解决的问题,也讨论了资料进入系统以后怎样形成证据、怎样参与主题演化。现在不需要重新构思一遍,而是要把这些分散在不同小节里的决定集中起来。
对于胶囊系统,因为可以让 Codex 去阅读第 10 章的内容,然后让他生成一份简报:
阅读第 10 章的内容,然后生成一份可以用于生成 SPEC 的需求说明,并存放在project目录下的 capsule-system 目录中。
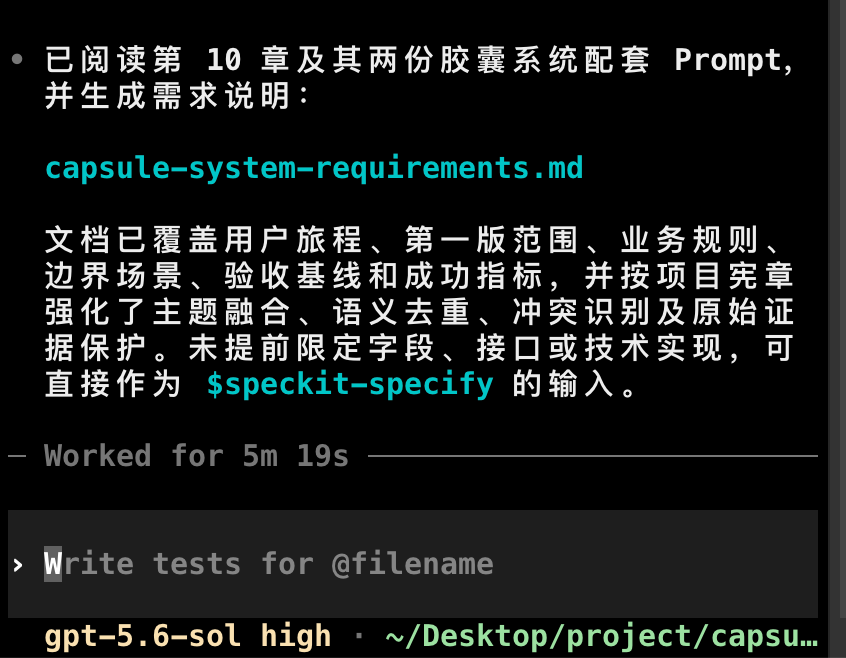
结合前面已经讨论过的设计,先得到下面这份需求简报:
# 胶囊系统主流程需求简报

> 用途:作为 `$speckit-specify` 的输入,生成胶囊系统第一版 SPEC。
>
> 来源:`gingery-wiki/hermes-logamee/book/第10章-胶囊系统:让知识真正进入你的思考`。
> 本简报按该章的完整设计整理,并以项目宪章为最高约束。

## 要解决的问题

资料被收藏或保存以后,往往只是在系统里多了一条孤立记录。用户仍然需要重新阅读,
重新判断它讲了什么,也不知道它是在重复、补充还是修正已有知识。资料越积越多,
知识结构却没有随之成长。

胶囊系统要解决的不是“把资料放到另一个收藏夹”,而是让外部资料经过接收、证据固定、
索引管理、关系理解、知识页演化和内化组织,逐渐变成用户可以反复阅读、引用和修正的
个人 Wiki。

## 使用者

本次先考虑个人用户。资料提交者、知识页使用者和不可逆操作的最终确认者是同一个人。

## 期望结果

一份资料进入系统后,不能停在“保存成功”。系统必须保留可核对的证据,记录处理状态,
判断它与已有知识的关系,并让相关知识页产生可解释的变化。

用户最终接触到的主要成果不是资料列表,而是持续演化的主题页、概念页、综合页、
当前判断和主题索引。原始资料仍然作为证据保留,用于回看和核对。

## 系统要完成的主流程

### 1. 接收资料

用户可以把 URL、网页、PDF、音频、图片或一段文字交给 Hermes。Hermes 是胶囊系统的
交互入口,具体从终端还是已接入的消息渠道提交,不改变后续处理规则。

系统首先处理能够直接确认的重复,例如相同 URL、相同文件或相同消息。入口去重只负责
拦截确定性重复,不能代替后续对内容价值的判断。

### 2. 固定证据

资料进入系统后,系统先将其转换为可检查、可引用的文本证据,再进行总结或理解:

- 网页需要抽取并清理正文。
- PDF 需要提取正文。
- 音频需要转写。
- 图片需要识别文字。
- 纯文本需要保留原意并整理成可阅读格式。

标准化证据应尽量完整,并保留回到原始来源的路径。原始载体在语气、版式、页码、图表
或其他信息具有核对价值时也应保留。证据和后续生成的知识页必须分开,知识页的改写不能
反向覆盖证据。

### 3. 建立资料索引

每份进入系统的资料都需要有可持续读取的索引记录。索引用于说明资料从哪里来、证据在
哪里、当前处理到哪一步、关联哪个主题、是否参与了知识页演化,以及系统为什么这样判断。

索引是证据与知识页之间的连接,也是中断后继续处理的依据。处理判断不能只存在于一次
对话中。

### 4. 理解资料关系

Hermes 读取证据后,需要形成结构化的理解结果,至少回答:

- 资料涉及哪些主题,应该进入已有主题还是形成新主题。
- 资料中真正有价值的关键观点是什么。
- 它与已有资料或知识页有哪些重复。
- 它补充了哪些新解释、新例子、新边界或新场景。
- 它是否修正或挑战了已有判断,冲突具体发生在哪里。
- 它以后适合在哪类写作、方案、回答或判断中被引用。

理解层负责回答“它与现有知识是什么关系”,但不直接把一份资料变成孤立摘要。

### 5. 演化知识页

系统根据理解结果更新长期存在的 Wiki 页面。更新必须是重新组织和融合,而不是把
“新增资料摘要”追加到页面末尾。

知识页分为三类:

- **主题页**:围绕一条可长期维护的知识线组织内容。新资料进入后,主题页可以延伸边界、
  补充案例、删除重复表达或校正旧判断,但仍应保持为一篇结构完整的文章。
- **概念页**:解释一个会被多个主题复用的基础概念,重点说明定义、边界、相近概念和
  典型用法,避免各主题页重复解释。
- **综合页**:围绕用户提出的具体问题,综合多个主题页、概念页和关键证据形成可复用回答,
  并保留它引用的知识页和证据。

新资料可以同时影响多类页面。系统必须判断应该新建还是更新页面,并控制页面粒度:
主题页不能粗到退化成资料仓库,也不能细到退化成标签列表。

### 6. 形成内化结构

系统不通过额外打卡、测验或强制复习让用户“内化”知识,而是把内化嵌入用户原本的阅读、
写作、方案和判断过程。

内化结构至少包括:

- **当前判断**:主题页中单独列出当前最核心、最有压缩力的判断。它不是永久真理,
  新资料进入后可以被修正。
- **主题索引**:维护一张可阅读的知识地图,让用户看到主要知识线及其相邻主题和概念。
  它不是机械文件列表,也不是要求用户维护的可视化知识图谱。
- **页面链接**:主题页链接相关概念页、综合页和关键证据;概念页链接使用它的主题;
  综合页链接引用过的主题、概念和证据。
- **输出调用**:用户写文章、做方案或回答问题时,Hermes 能重新调用相关知识页,
  而不是每次只从原始资料临时生成一次性答案。

## 资料采纳、重复与冲突

入口去重和内容去重必须区分:

- 入口去重处理相同 URL、文件或消息等确定性重复。
- 内容去重判断一份不同资料是否给现有知识带来新增价值。

只要资料补充了一个有效例子、边界、解释或修正,就视为参与了本次演化,并只融合新增
部分。对当前知识页没有任何帮助的资料可以标记为“不被采纳”,不再进入主题演化,但系统
必须保留其处理记录和判断理由。

冲突内容不能被静默覆盖或强行合并。系统需要指出被挑战的既有判断、冲突的新观点以及
双方证据,并让相关知识页保持可核对。

系统可以建议不采纳或删除证据,但未经用户针对明确对象作出确认,不得永久删除原始证据。
“不参与演化”“不被采纳”“建议删除”和“永久删除”必须是不同的处理结果。

## 用户能够看到什么

一份资料完成处理后,用户应能够:

1. 找到可核对的证据,并回到原始来源。
2. 查看该资料当前的处理状态和系统判断理由。
3. 知道它关联或创建了哪些主题。
4. 知道它更新了主题页、概念页还是综合页。
5. 看出哪些内容被采纳、哪些内容重复、哪些内容存在冲突。
6. 打开更新后的知识页,看到融合后的完整内容,而不是新增资料列表。
7. 从当前判断、主题索引和页面链接继续阅读或用于真实输出任务。

## 必须遵守的约束

1. 任何资料处理流程都不能只新增一条记录后结束。
2. 知识页中的重要判断必须能够回到相关证据核对。
3. 整理后的知识页不能替代或覆盖证据。
4. 自动判断可以决定资料是否参与本次演化,但不能自动永久删除原始证据。
5. 所有采纳、不采纳、重复和冲突判断都必须留下可检查的结果和理由。
6. 系统规则必须稳定执行,不能只依赖当前对话里的临时约定。
7. 需求阶段不预先决定数据库、接口、页面框架、脚本语言或具体工具实现。

## 本次不处理的事情

- 不把胶囊系统做成只会关键词检索或临时生成回答的普通 RAG 系统。
- 不把每份资料保存成一篇孤立摘要。
- 不把内化设计成独立的打卡、测验、背诵或强制复习流程。
- 不把知识图谱做成要求用户查看和维护的大型可视化关系图。
- 不要求所有具体、短期、工具性知识都进入用户的当前判断。
- 不在本需求简报中展开技术选型、数据模型、接口设计和任务拆分。

## 希望验证的结果

使用一组包含新增、重复、补充和冲突关系的真实资料走完主流程后,应当能够验证:

1. 每份资料都有可核对的证据和可读取的处理记录。
2. 系统能够说明资料与已有主题的关系,而不是只生成资料摘要。
3. 被采纳的内容真正融合进对应知识页,页面仍然是一篇结构完整的文章。
4. 重复表达没有被反复写入知识页,新增价值没有因去重而丢失。
5. 冲突观点及其证据保持可见,旧判断没有被静默覆盖。
6. 用户能够看出资料影响了哪些主题页、概念页或综合页,以及为什么这样处理。
7. 主题页保留可被后续资料修正的当前判断,全局主题索引能够展示正在形成的知识线。
8. 任何不采纳或建议删除的资料,在用户确认前都没有发生原始证据永久丢失。
9. 即使一次对话中断,Hermes 也能根据证据、索引和知识页继续处理。
10. 用户可以从知识页重新阅读、写作或做判断,而不必每次从原始资料重新开始。

## 生成 SPEC 时的要求

生成的 SPEC 应围绕上述完整主流程组织可独立验收的用户场景,并明确主题页、概念页和
综合页的区别。它必须同时检查当前项目宪章中的三条原则:

1. 新资料必须经过关系判断和知识页演化,不能只增加一条记录。
2. 未经用户确认,系统不得永久删除原始证据。
3. 系统遇到会影响证据、知识内容或不可逆状态的重要不确定情况时,必须暂停受影响的操作并交给用户决定;人工决定不得自动成为全局规则。

SPEC 不应在需求阶段替项目决定具体存储产品、字段、接口或技术实现。
这份简报没有继续讨论数据库、接口或页面框架。好了,现在思考下,该干什么。
答案是认真查看、审阅,提出修改意见。
1.3 这份简报还需要人工检查
需求简报是草稿,不是 Agent 说了算。我们至少要检查三件事:完整主流程是否覆盖了前面确定的主要职责;主题页、概念页和综合页的区别是否已经写清楚;原始证据和用户确认之间的关系有没有被写清楚。
如果这三件事还没有答案,就不应该急着进入 $speckit-specify。继续追问或直接修改简报,成本都比写完代码以后返工低。只有当我们确认这份简报表达的是自己的决定,而不是 Agent 顺手补出来的一套产品设想,才适合交给 Spec Kit。
1.4 停下来
现在是一个你练习的好机会。停下来,重新阅读第十章。然后尝试找出需求里有什么问题,可以尝试借助 grill-me。然后修正这份需求文档。
1.5 从需求简报进入 SPEC
现在,胶囊系统有了项目宪章,也有了第一份功能需求简报。下一节会在项目目录中引用 $speckit-specify,让 Spec Kit 读取这两份输入,生成结构化的初版 spec.md。
这一节先停在需求简报。技术选型、数据模型和任务拆分,都留到 SPEC 经过澄清以后再决定。
1.6 ■ 学点英语
| 中文 | English | 音标 | 说明 |
|---|---|---|---|
| 个人 Wiki | Wiki | /ˈwɪki/ | 可以被持续编辑、链接和维护的知识页面集合 |