这一节先梳理第一版到底接收哪些资料形态,再逐一决定它们怎样形成证据。前面的需求里,我们讨论的非常含糊,这里有必要对资料范围进行收敛。 收敛对于 Vibe-Coding 非常重要。如果不收敛,很容易造成过度开发。人类的思维总是倾向于发散。所以,我必须要认真的对大量的需求做鉴定和收缩。一个不裁剪,不分阶段的项目,肯定是一个失败的项目。
3.1 收敛依据
需求裁剪最困难的地方,往往不是不知道有哪些方案,而是不知道哪些应该要,哪些可以不要。同一个需求,有人认为必须保留,也有人觉得完全没有必要。这里没有一套适用于所有项目的答案。所以,在收敛具体需求之前,必须先对当前项目做一个完整的定位。
胶囊系统首先是一个个人知识库。它主要满足个人的学习和记录需求,帮助我们把日常接触到的资料整理成以后可以继续使用的知识。它和企业里用于生产、研发或业务协作的知识库并不一样。后者可能直接参与产品开发、客户交付和重要决策,一条证据缺失或失真,都可能带来实际的业务后果。
理解清楚这个定位,非常重要。
我认为,这两类知识库最大的区别,在于个人知识库应该更加轻量。对于证据来源是否完整、原始资料是否长期保存,没有那么严苛。它可以允许一定程度的容错。企业生产知识库则不能如此随意。它通常需要更严格的来源追溯、原件保存、权限控制和审计记录,有时还必须满足组织内部的合规要求。
当然,企业知识库是一个极其庞大的话题,那肯定不是我们这个综合教材能够表达的。他需要涉及到 Agentic RAG、Graph 知识图谱等。企业知识库的目的也同个人知识库不同。
这就是整个项目的底色:我们做的是一个服务个人学习和记录的知识库,而不是一套用于生产环境的证据管理系统。后面无论是放弃 PDF 里的图片,还是不保留原始音频和视频,都是在这个底色上做出的需求裁剪。以后遇到“这个到底要不要”的问题,也可以先回到这里,看看当前选择是不是仍然符合这个项目的定位。
所以,搞清楚项目的底色,对于裁剪需求非常重要,希望同学们可以借鉴我的思路。下面我们根据这个底色,来对需求做裁剪和收敛。
3.2 资料接收范围
前面的需求简报直接把 URL、网页、PDF、音频、图片和文字都列进了接收范围,但这还不够。不同资料形态携带信息的方式不一样,系统不能用同一套规则处理它们。
第一版先接受六类资料。前五类是单一形态,最后一类是文字、图片和视频混在一起的复合资料。
| 资料形态 | 常见来源 | 第一版处理方向 |
|---|---|---|
| 纯文本 | 用户输入、.txt、消息正文 |
直接作为文字证据 |
| PDF 文档 | 电子书、论文、报告、扫描文档 | 提取文字证据,不处理 PDF 中的图片 |
| 纯图片 | 截图、照片、图表、扫描页 | 识别图片中的信息,形成文字证据 |
| 纯音频 | 录音、播客、语音消息 | 转写为文字证据 |
| 纯视频 | 课程、演讲、视频文件 | 形成文字证据 |
| 复合资料 | 微信公众号文章、HTML 页面 | 保留 URL,并把有价值的内容清洗成文字证据 |
这里的“复合资料”是对这类混合内容的工作称呼。第一版只处理网页,因为微信公众号文章和普通 HTML 页面都可能同时包含正文、图片、视频、广告和其他页面资源。
Word、Excel、PowerPoint 等其他格式,第一版暂不接受处理。
3.3 两层证据
这里还要区分两层证据: 1. 原始证据,指视频、PDF、网页 URL。这类原始证据,如果有 URL,则只保存 URL。如果没有 URL,比如用户发了一段音频,则音频提取文字后,直接丢弃(不是删除,只是不记录,不保存)。 2. 清理、提取后的证据,我们称为”衍生证据“。
比如,一份 PDF,他是原始证据,但是将其提取成纯文本、去掉图片后的文本属于“衍生证据”。
在胶囊系统中,我们会保存原始证据的 URL 和 “衍生证据”。衍生证据通常是文本。
但对于复合材料,会有一些不同,这个我们后面讨论。
3.4 纯文本证据的处理规则
纯文本没有复杂的载体问题。用户提交的文字可以直接作为证据,系统只需要保留原意,必要时整理段落和格式,不能在接收阶段把它改写成摘要。
后续的主题判断、去重和融合都应该建立在这份文字证据上。知识页可以重新组织内容,但不能反过来覆盖这份处理后的证据。
3.5 PDF 统一转换成文字
PDF 一律转换成文字。文字型 PDF 直接提取正文,扫描型 PDF 通过 OCR 识别文字,再清理页眉、页脚、页码和其他版面噪音。系统不保留原 PDF,也不处理 PDF 里嵌入的图片。
如果 PDF 来自一个 URL,这个 URL 作为原始证据保存,抽取出的文字作为衍生证据保存,两者保持关联。如果用户直接提交 PDF 文件,没有 URL,那么系统只留下抽取后的文字,不保存原始文件。
这个选择会放弃 PDF 中的版式、图表和其他视觉信息,PDF 在胶囊系统里只是一种文字来源,不承担原文件归档的职责。
3.6 独立图片的证据成立条件
纯图片和复合资料里的图片不是同一种判断对象。复合资料里的图片可以借助正文、标题、图注和页面位置理解;纯图片没有这些上下文,只能把图片本身当作一个独立对象来判断。
因此,纯图片只有在自身已经构成完整、可独立理解的知识证据时,其中的信息才值得转换成文字进入知识系统。判断的重点不是“它有没有可能和某个主题有关”,而是“它自己能不能形成一个独立的文字知识片段”。图片里的文字、标题、图例、坐标、标注或结构,必须足以让人判断它在表达什么。表格、流程图、公式、地图、带明确标注的数据图,以及能够说明操作状态的截图,通常符合这个条件。
反过来,单独提交的风景图、头像、装饰图、广告图或普通照片,如果独立存在,通常不被认定为知识。它们只有夹在有意义的正文、图注或其他证据中时,才可能因为上下文而获得价值。脱离上下文以后,图片本身不能完整表达知识,就不应进入知识内容。比如,这张图片:
这里值得讨论的是,一张风景图是否属于”知识“。以摄影风景为例,我认为不属于。一张风景图如果独立存在,没有依附于其他上下文,那么它应该属于摄影、壁纸类多媒体,这本身不应该进入到以文字为主的知识库。当然,你可以为自己的摄影作品配上文字上下文,这样可以算作摄影知识的一部分。比如,你可以输入一张图片,然后再附带一段 Prompt:这张作品拍摄于 2026 明年 8.11 日,参数是什么。
每个人对于知识的界定会有差异,也会造成需求文档的不一致。所以,我常说,Agent 时代每个人的作品都是独一无二的。但不管怎么样,需求文档最重要的就是”讲清楚”,这一点是共同的。
判断完成以后,图片中有价值的信息会被识别并清洗成文字,图片文件本身不保留;如果图片来自 URL,则另外保存 URL 作为原始证据。
3.7 音频与视频的证据转换规则
纯音频的主要信息通常在声音内容里,纯视频的讲解内容通常可以通过字幕或转写稿进入文字证据。因此,第一版对这两类资料只要求形成可阅读、可检索的文字证据。
它们不作为知识页中的独立媒体对象保存,原始音频和视频文件也不进入证据层。如果资料来自 URL,系统只把 URL 作为原始证据保存。
流转规则:
音频、视频 -> 转写并清洗 -> 文字证据
如果音频或视频来自链接,则有两层证据:URL 形式的原始证据和转写后的文字证据。直接提交的媒体文件没有原始证据,只有处理后的文字证据。这个时代的信息太泛滥了,如果只是个人的兴趣、爱好,非工作知识,保不保存原始多媒体没有多大意义。
可能你想的很多,但是最后发现,保留一大堆视频、音频毫无用处。我个人的原则是能要文字的,绝不要其他格式的媒体。
3.8 复合资料的内容保留规则
这是最麻烦的一类。微信公众号文章和普通 HTML 页面往往同时包含正文、图片、视频、广告和跟踪资源。第一版把网页 URL 保存为原始证据,再抽取并清洗页面内容,形成文字证据。
复合资料的处理边界是:正文进入文字证据;图片结合正文和图注判断,有价值的信息转换成文字,但不保留图片文件;视频、音频和其他媒体也不单独保存。广告、装饰资源和其他无关内容直接排除。这样,网页最终只留下两样东西:作为原始证据的 URL,以及作为处理后证据的清洗文本。
复合资料中的图片判断标准
复合资料里的图片可以结合正文、标题、图注和页面位置判断。图片即使不能独立表达完整事实,只要它是正文不可替代的补充,忽略后会使证据不完整,就应当把其中的信息转换成文字;广告、装饰资源和与正文无关的图片则不进入知识内容。
但这其实是最难的一类判断。
以下图片均来自于我的微信公众号“林间有风”
这种图片里的信息应该转成文字证据吗?我个人认为不需要,因为它本身没有增加新的信息,只是在佐证观点或者加深印象。
再比如,这种:
同样是这个问题,没有增加新的信息,原则上我认为不需要再把它转换成文字。
那什么样的信息应该转成文字证据呢?这种:
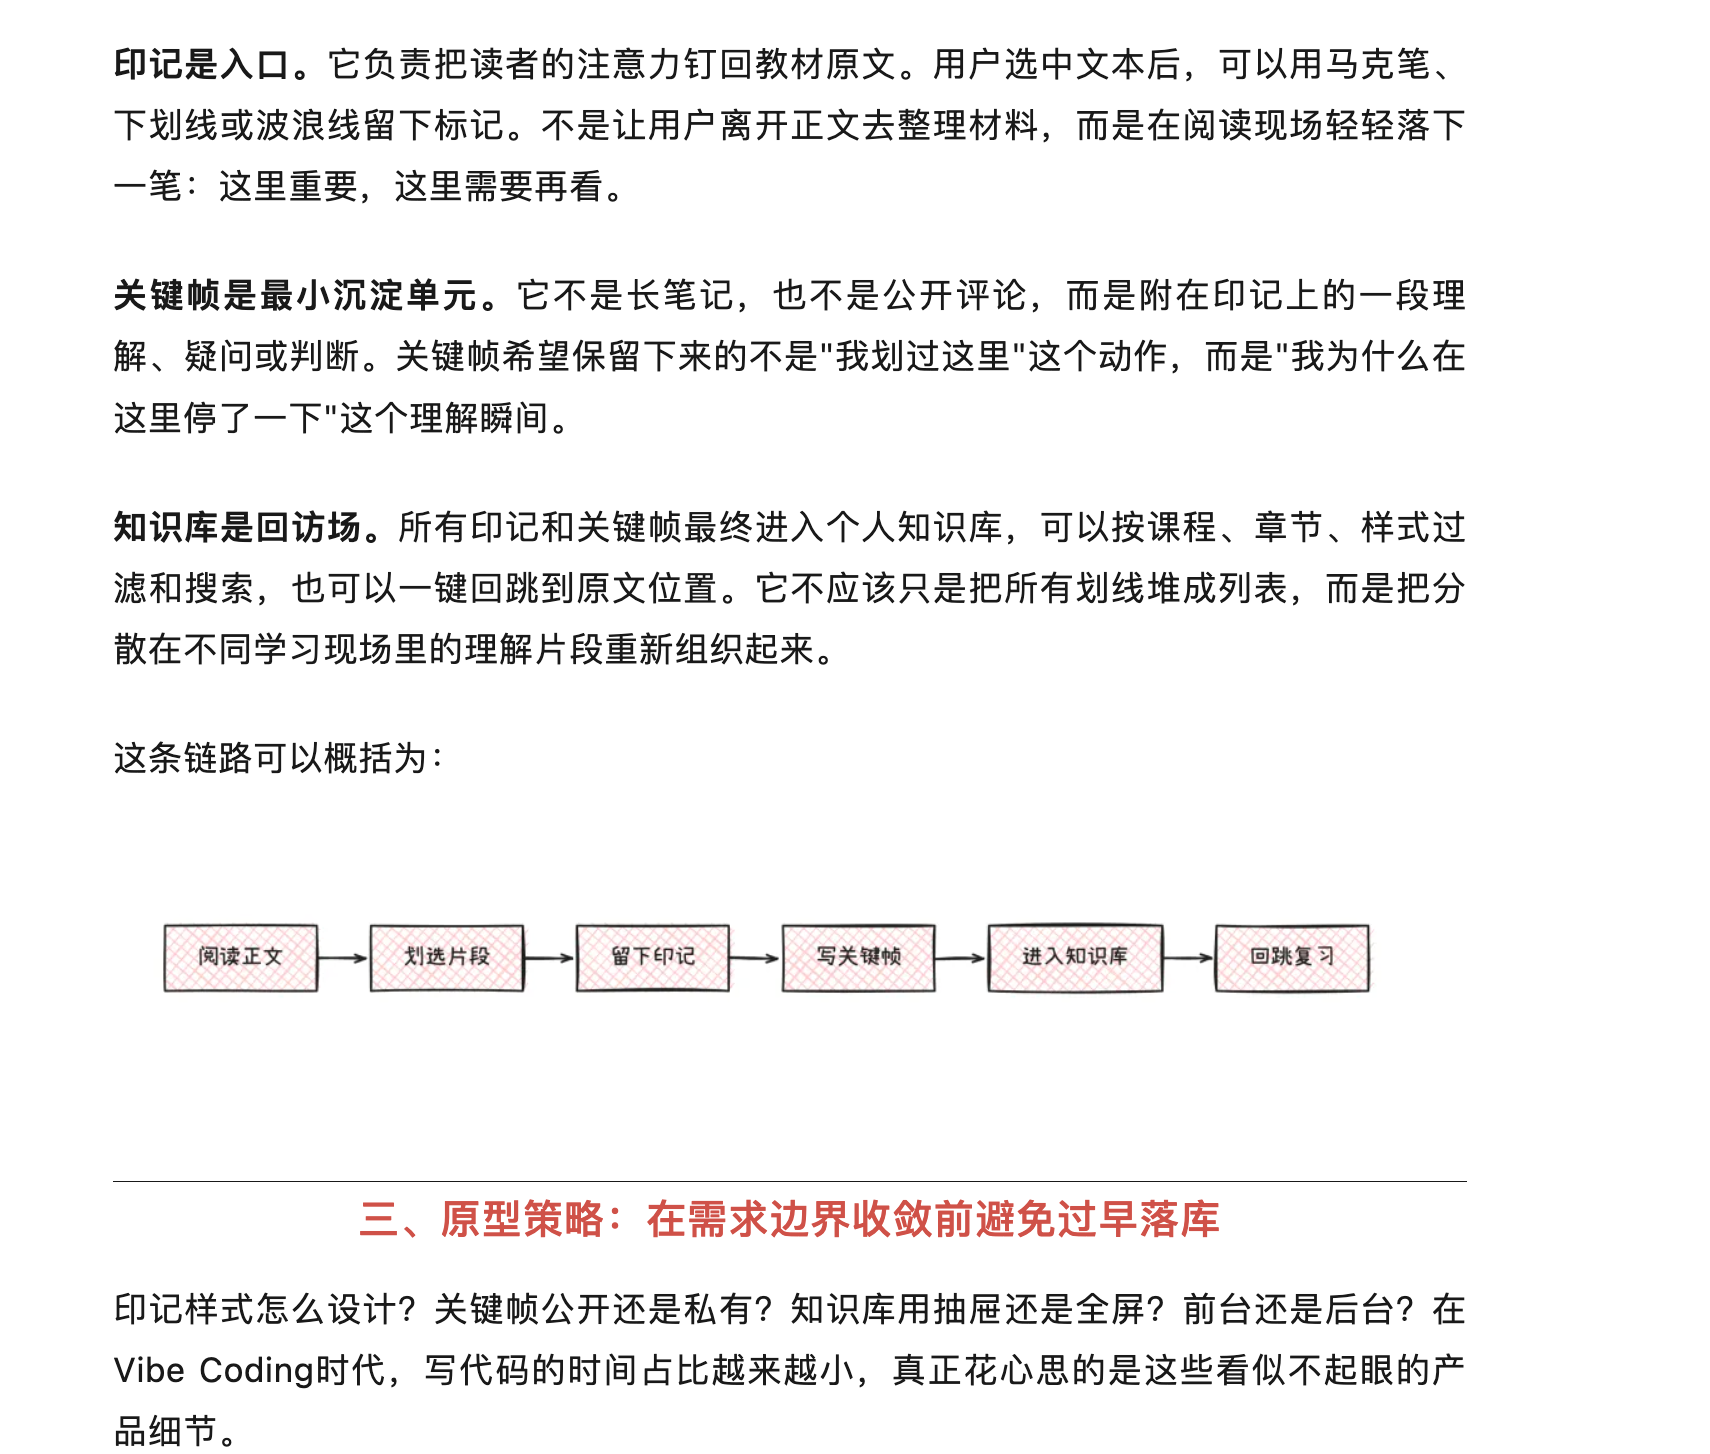
这种:
它属于知识本身的一部分,不是为了渲染、加强或增强说服力,所以应当识别出来,转换成文字证据。
如果上下文不足以确认图片的作用,只能把它标记为待确认,不能擅自把无法识别的内容编成文字。无论判断结果如何,图片文件本身都不进入证据层;网页的原始证据仍然是它的 URL。
你看,其实想想就知道有点难,这100%需要用到视觉模型,且需要模型有不错的推理能力。