启动 $speckit-plan 时,技术背景可以直接写在 Prompt 中,也可以先整理成 Planning Brief。这两种方式的差别,不在于 Plan 会生成什么,而在于技术背景由哪里保存和维护。
6.1 直接在 Prompt 中输入
如果只有两三条当前功能特有的技术限制,可以直接写在 $speckit-plan 后面。比如,一个小型功能已经确定使用 Python,但存储方式还需要调研,可以直接输入:
$speckit-plan
使用 Python 开发;不建设 Web 页面;存储方式交给 Phase 0 调研。
这种方式不需要额外文档,Prompt 本身就是 Plan 的补充技术输入。它适合内容少、只在当前一次规划中使用的情况。但是,当技术限制、初步建议和开放问题慢慢增多,再把它们全部塞进 Prompt,就不是太合适了。
6.2 通过 Planning Brief 输入
Planning Brief 适合保存需要单独审查、反复修改和多次使用的技术背景。它把完整内容放在一份文档中,Plan Prompt 只负责指出这份文档在哪里。
这里有一个边界必须保留:Planning Brief 是我们为项目增加的辅助文档,不是 Spec Kit 的标准文件。Spec Kit 不会自动创建它,$speckit-plan 也不会自动发现它。所以,Brief 保存到项目以后,必须在 Prompt 中写出它的路径。
胶囊系统的正式 Brief 保存在 specs/001-capsule-main-flow/planning-brief.md。
在这种方式下,Brief 保存技术方向、调研要求和输出边界;Prompt 只是一个入口,告诉 Agent 去读取 Brief。如果把 Brief 的内容再复制到 Prompt 中,两份内容以后就要同时维护,这正好违背了我们增加 Planning Brief 的初衷。
6.3 胶囊系统采用 Brief 方式
虽然大多数人喜欢随手输入 Prompt,但我还是认为如果是一个严肃的项目,任何步骤都需要留痕。
因此,胶囊系统不会把完整技术背景写进 Prompt,而是使用 Planning Brief。
有了 Brief,就不要输入大段的 Prompt 了,真正需要输入的 Plan 指令可以很短:
$speckit-plan

请读取 `specs/001-capsule-main-flow/planning-brief.md`,
将其作为当前功能的补充技术输入,并结合当前
`spec.md` 和项目宪章完成 Plan。
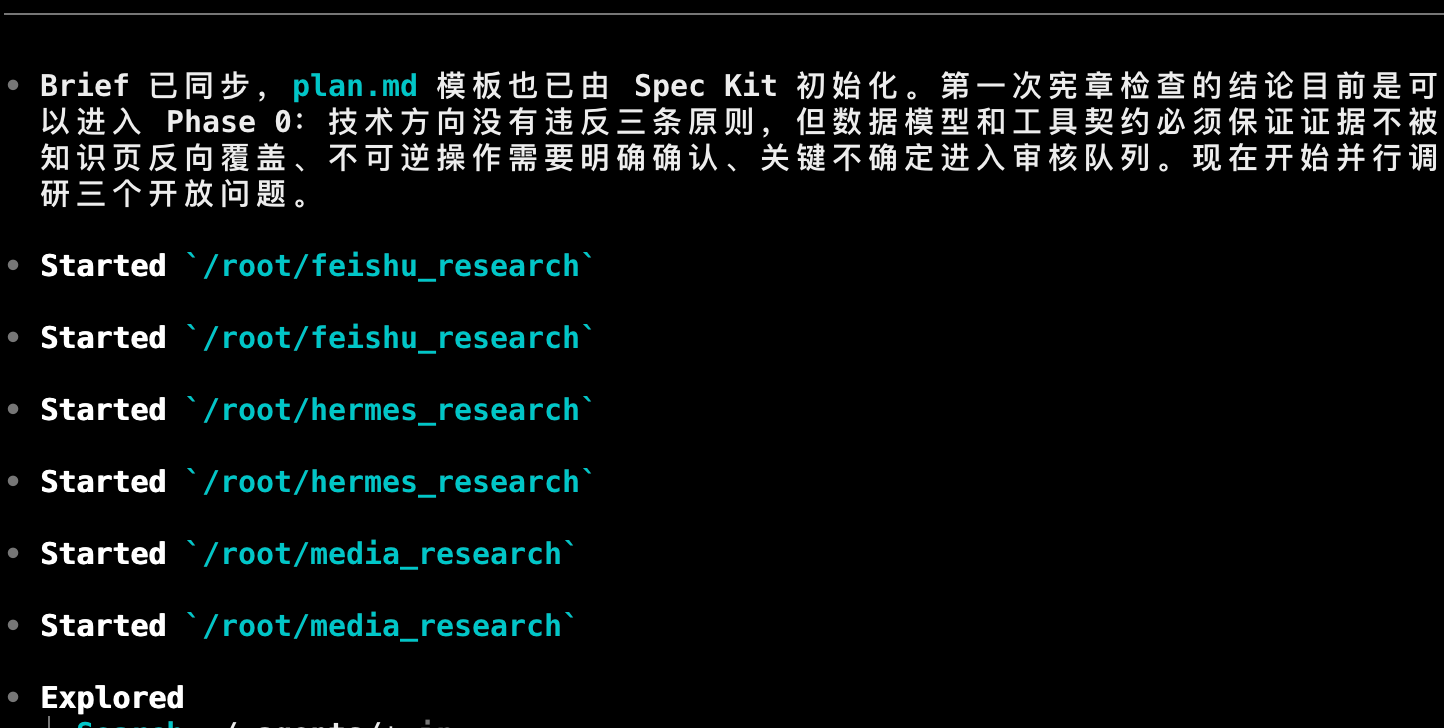
这就是本项目实际执行 Plan 时使用的指令,不是为了讲解而缩写出来的示例。Codex 收到指令后,会先定位当前功能,再读取 SPEC、宪章和 Planning Brief。下面的截图记录了这次 Plan 启动时的情况:
6.4 查看这次 Plan 的真实产物
Plan 完成后,打开当前功能目录:
胶囊系统的 Plan 产物位于 specs/001-capsule-main-flow/。
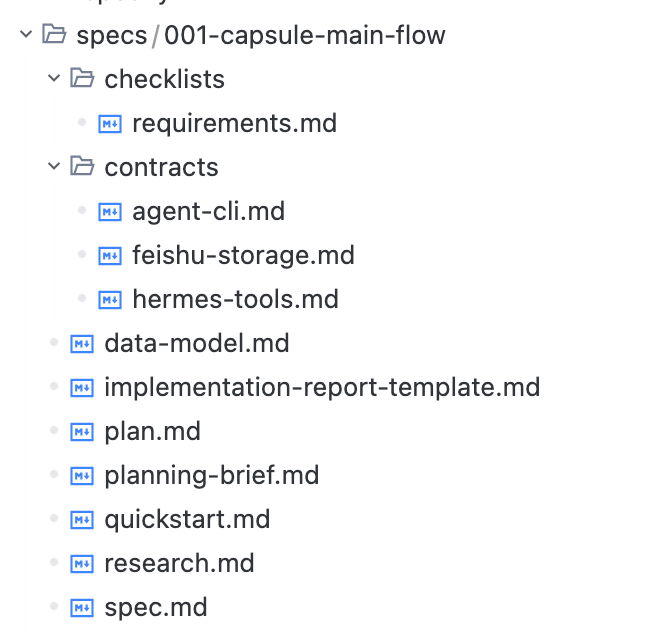
截图里文件很多,但真正需要审查的 Plan 产物主要是下面五组:
| 产物 | 这次规划中承担的任务 |
|---|---|
plan.md |
汇总技术上下文、整体架构、宪章检查、源码结构和复杂度取舍 |
research.md |
保存阶段 0 的技术决定、理由、替代方案和调研依据 |
data-model.md |
把资料、证据、知识页和审核项变成可以实现的数据对象与状态关系 |
contracts/ |
规定 Agent 怎样调用 CLI,以及 Python 怎样把终态结果写入飞书 |
quickstart.md |
提前拟定项目完成后的使用和验收方法,列出操作步骤和预期结果 |
Spec Kit 重新执行 Plan 时不会自动删除历史文件,所以人工审查不能只看目录里有什么,还要看 plan.md 当前引用了什么。
6.5 从真实内容理解这些产物
前面的表格只能让我们大概知道文件分工,真正审查 Plan 时,还要打开文件,看看SPEC Kit 给你的 Plan 文档是否符合你的要求。由于每份文档太长,我们只截取部分有代表性的原文作为说明,原始文档请参考项目资料。
位于:profile/capsule-system/specs
plan.md:确定整体技术方案
plan.md 的主要作用,是把 SPEC 转换成一套完整的实现方案。它要确定项目采用什么形态、技术怎样组合、源码怎样组织,同时检查这些选择有没有违反宪章。比如,这次 plan.md 对项目类型作出了明确规定:
项目类型:由通用 Agent 基座主控、通过 Skill 和 Python CLI 运行的模块化单体 SE 产品;不建设 HTTP 服务、独立前端或 HTML 审核界面。
这句话同时确定了架构和排除项。后面实现时可以继续设计类和函数,但不能擅自把项目改造成 Web 服务。这正是 plan.md 应该承担的任务:它不负责列出每个字段,却要让所有模块沿着同一个技术方向开发。
此外,plan.md中还规定了项目的开发语言:python 等信息。
research.md:保存技术决定及其依据
research.md 的主要作用,是记录一些不是 100%肯定的技术方案是怎么确定的。技术方案的选择不能只有结果,还要说明理由和被放弃的方案。
比如,对于是否增加本地状态库,这次调研写成了三个连续部分:
决定:飞书是唯一的长期业务数据层,第一版不使用 SQLite、outbox、本地状态库或持久化任务队列。
理由:飞书云文档、知识库和多维表格之间没有共同事务,因此无法在不引入状态管理的情况下提供严格的跨资源原子性。第一版采用“先计算,后提交”缩短风险窗口:先完成全部内容与约束检查,再创建完整证据、更新知识页,最后写入 Base 终态记录,并重新读取关键资源核对结果。
考虑过的替代方案:建立 SQLite 和 outbox 可以增强恢复能力,但违反最新 Brief 对第一版复杂度的限制。
这组内容比只写一句“不使用 SQLite”要更加有意义。以后项目规模发生变化,我们可以重新检查当初的限制是否还成立,再决定要不要修改方案。research.md 保存的就是这种可以回头核对的决策过程。
记得之前我们在做 brief 的时候其实对 plan 有确定和不确定的级别之分。在启动plan 的时候,截图里也显示了其实 codex 会启动几个子 agent 去做调研。而 research.md 就是这些调研的结果。
data-model.md:把需求中的对象变成可实现的数据结构
data-model.md 的主要作用,是定义系统要长期处理哪些对象,每个对象保存什么,以及对象怎样改变状态。SPEC 只要求系统生成审核项并展示必要信息;到了数据模型中,“审核项”被展开成了具体字段:
| 字段 | 这次数据模型中的规定 |
|---|---|
review_type |
区分处理中断、知识冲突和不可逆操作 |
trigger_code |
保存可以检查的触发条件,不能只依赖模型自报的置信度 |
detected_stage |
记录发现问题的业务步骤,但不能作为恢复游标 |
allowed_decisions |
保存稳定的决定代码、显示名称及后果 |
suggested_next_task |
保存用户决定后可以启动的新任务及所需输入 |
这几个字段把“人工审核”从一句需求变成了 Python 和飞书都能准确处理的对象。尤其是 detected_stage 与 suggested_next_task,它们落实了刚刚确定的一次性任务规则:系统可以说明问题发生在哪里,也可以建议下一项任务,但不能恢复原来的执行现场。
其实如果你以前是个Java 程序员,应该很容易理解 data-model,很类似我们常说的 ORM 中的 Model。很多东西其实只是换了一张皮,骨子里还是那么个事儿。
contracts/:规定模块之间怎样交换信息
contracts/ 的主要作用,是固定系统边界。胶囊系统没有 HTTP API,但 Agent、CLI、Python 和飞书仍然需要对命令、返回值和写入顺序形成共同约定。比如agent-cli.md 对人工审核结果规定:
review_required:当前任务已经生成审核项并结束,result_refs必须包含审核项引用。
而 feishu-storage.md 对写入边界规定:
任何一步失败都不得写入证据、知识页或终态记录。需要用户判断时,只创建完整审核项并结束当前任务。
前一句约束 Agent 怎样理解 CLI 返回值,后一句约束 Python 怎样写飞书。它们共同证明,契约不是架构说明的重复,而是在规定模块交界处允许发生什么。实现可以更换内部函数,但这些约定不能被悄悄改掉。
契约很像传统编码时代的接口说明文档,规定了一系列的规范。举个你能理解的例子,HTTP 的状态码 404、403、200 这些其实就是契约。很多东西,不要被吓到,其实就是常规的一些概念换了个场景。
quickstart.md:提前设计项目完成后怎样验收
quickstart.md 的作用,是在编码以前先拟定一份“项目完成后怎样使用和验收”的说明。此时代码还没有写,文档中的命令当然也不能真正执行。Spec Kit 现在做的只是提前写好操作步骤和预期结果,等代码完成以后再真正执行。
这里最容易混淆的,就是“拟定”和“执行”两个动作:
Plan 阶段:拟定验收方法,此时不执行
      ↓
开发阶段:实现文档中约定的命令和系统行为
      ↓
开发完成:实际执行这些操作,核对结果是否符合预期
为什么要在编码以前就写这份说明?因为 Plan 可能已经决定使用 Python、CLI 和飞书,却没有交代系统从哪里启动、飞书测试空间怎样初始化,或者冲突发生后应该出现什么结果。在 quickstart.md 里提前写验收步骤,就会迫使 Plan 把这些问题补齐。它检查的是开发计划是否完整,不是检查代码是否正确。
胶囊系统的 quickstart.md 中就提前写了这样一条验收操作:
分别提交新增、补充、重复和冲突资料。新增或补充内容推动主题页或概念页演化;重复文字不再次写入;冲突会暂停流程,而不是替换原有判断。
这段话目前只是预先写下的验收标准,并不表示这些功能已经可以使用。但它会反过来约束开发:系统必须能分辨新增、重复和冲突资料,也必须让用户看到对应结果。等开发完成,开发者和 Agent 再真正提交这些资料,把实际结果与文档中的预期结果逐项对照。
把这五组文件连起来看,顺序就很清楚了:plan.md 确定整体方案,research.md 保存方案的来由,data-model.md 和 contracts/ 把方案推进到对象与接口,quickstart.md 则提前写好项目完成后的验收方法。它们共同组成 Plan。
强烈建议同学们在这组文件上反复审阅、打磨,这可以有效的提高 Agent 的工作质量。